Veri Gölleri Nedir ve İşletmelere Nasıl Katkı Sağlar?
Veri gölleri nedir? Veri ambarlarından farkını, işletmelere sağladığı analitik katkıları ve güvenli, yönetilebilir bir yapı için gerekenleri şimdi öğrenin.
- Ham veriyi özgün biçiminde saklamak, analiz ihtiyacı netleştiğinde farklı kullanım senaryolarını değerlendirmeyi kolaylaştırır.
- Veri ambarı ile göl mimarisi arasındaki seçim, verinin türüne ve raporlama ya da keşif ihtiyacına göre şekillenir.
- Şemanın okuma sırasında uygulanması esneklik sağlar; verinin anlamlı ve tutarlı kullanılabilmesi için dönüşüm ve kalite süreçleri gerekir.
- Kataloglama, erişim denetimi ve veri kökeni yönetimi, düzensiz ve güvenilmez bir veri birikimini önlemeye yardımcı olur.
- İşletmeler, farklı kaynaklardaki verileri bir araya getirerek analitik, tahminleme ve makine öğrenmesi çalışmalarına zemin hazırlayabilir.
Analitik kararların kalitesi, veriye erişimin kolaylığı kadar verinin nasıl yönetildiğine de bağlıdır. İşletmeler farklı kaynaklardan gelen verileri birlikte değerlendirmek ister; ancak depolama, kullanım ve erişim kuralları net değilse yeni analiz ihtiyaçlarını karşılamak zorlaşabilir.
Esnek bir veri mimarisi, ekiplerin değişen iş sorularına yanıt bulmasını destekler. Bunun için veri kalitesi, güvenlik ve yönetişim ilkeleri de tasarıma dâhil edilmelidir. Böylece analitik ortam, yalnızca veriyi biriktiren değil, kontrollü kullanıma açan bir yapıya dönüşür.
Bu yazıda veri göllerinin nasıl çalıştığını, veri ambarlarından hangi yönleriyle ayrıldığını ve şema okuma yaklaşımının etkisini ele alıyoruz. Ayrıca işletmelere sağladıkları katkıları, kullanım alanlarını ve tasarım sırasında karşılaşılabilecek yönetişim, performans ve güvenlik zorluklarını inceliyoruz.
Veri Gölü Nedir?
Veri gölleri, farklı kaynaklardan gelen büyük hacimli verileri özgün biçimlerinde saklayan merkezî depolardır. Yapılandırılmış tabloların yanı sıra günlükler, görseller ve CSV dosyaları da burada tutulabilir. Bu nedenle veri gölü, henüz belirli bir raporlama ihtiyacına göre düzenlenmemiş verileri de barındırır. Veri alınırken her alan için önceden bir şema tanımlanması gerekmez. Yapı çoğunlukla veriler okunurken veya dönüştürülürken uygulanır.
Veri gölünü veri ambarından ayıran temel nokta bu esnekliktir. Veri ambarında veriler depoya yazılmadan önce hazırlanır ve tanımlanmış ilişkisel bir şemaya göre düzenlenir. Örneğin satış kayıtları, müşteri ve ürün tabloları arasındaki ilişkilerle raporlamaya uygun hâle getirilir. Veri gölünde ise aynı kayıtlar kaynak biçimleri korunarak saklanabilir. Bu yaklaşım, büyük veri hacimlerini farklı analiz ihtiyaçları için bir arada tutmaya elverişlidir.
İki mimari farklı veri türleri ve iş amaçları için öne çıkar. Veri ambarları çoğunlukla yapılandırılmış, bazen de yarı yapılandırılmış verilerle çalışır. Tutarlı raporlama, temel iş zekâsı ve sorgu performansı için düzenlenir. Veri gölleri ise yapılandırılmış ve yapılandırılmamış içeriği kabul eder; keşif, makine öğrenmesi ve gelişmiş analitik çalışmalarında farklı biçimlerdeki verileri bir araya getirebilir. Ham veri, gerektiğinde analiz için işlenir.
İş akışı bu ayrımı somutlaştırır. Örneğin bir işletme, çevrim içi mağazasının işlem kayıtlarını, uygulama günlüklerini ve müşteri destek notlarını veri gölüne alabilir. İlk aşamada kaynak dosyalar korunur. Müşterilerin sepeti hangi aşamada bıraktığı gibi bir soru gündeme geldiğinde ilgili veriler seçilir, temizlenir ve ilişkilendirilir. Ardından raporlama için veri ambarına aktarılabilir. Böylece keşif ortamı ile standart raporlama katmanı birbirinden ayrılır.
Seçim, verinin biçiminden çok kullanım amacına bağlıdır. Finans ekibinin düzenli satış raporları için doğrulanmış ve tutarlı tablolara ihtiyacı olabilir; veri ambarı bu amaca uygundur. Ürün ekibi ise tıklama kayıtlarıyla destek taleplerini birleştirerek kullanıcı davranışlarını araştırabilir. Veri gölü, bu tür keşiflerde farklı kaynakların özgün verilerini korur. İki yapı birbirinin alternatifi olmak zorunda değildir; işletmeler analitik süreçlerinde ikisini birlikte kullanabilir.
Veri gölündeki esneklik, yönetişim gereksinimini ortadan kaldırmaz. Örneğin müşteri dosyalarını saklayan bir mimaride veri sahipliği, erişim yetkileri ve saklama kuralları tasarlanmalıdır. Türkiye’de kişisel verilerin korunmasını düzenleyen kanun 6698 sayılı Kanun’dur; bu bilgiyi T.C. Cumhurbaşkanlığı Mevzuat Bilgi Sistemi belirtir. Kişisel veri içeren kayıtların mimaride nasıl ele alınacağı, güvenlik ve erişim tasarımının parçasıdır.
Veri gölü, yalnızca geniş bir depolama alanı değildir. Kaynak veriyi koruma, uygun zamanda dönüştürme ve analiz için erişilebilir kılma yaklaşımıdır. Veri ambarı ise önceden düzenlenmiş verilerle tutarlı raporlama sağlar. Örneğin ham uygulama kayıtları gölde saklanırken onaylanmış satış ölçümleri ambar üzerinden raporlanabilir. Mimari seçerken veri çeşitliliğini, analiz ihtiyacını ve yönetim modelini birlikte değerlendirmek gerekir.
Veri göllerinin zorlukları nelerdir?
Veri bataklığı, kataloglanmayan ve güvenliği yönetilmeyen ham verilerin bulunamadığı, güvenilirliğini yitirdiği ortamdır. Sağlıklı bir gölde her veri kümesi; kaynağı, sahibi, içeriği, güncellenme sıklığı ve erişim bilgileriyle tanımlanır. Örneğin satış günlüklerinin sahibi ve kullanım amacı kaydedilmezse, analistler aynı veriyi farklı yorumlayabilir. Katalog, veri kökeni ve kalite kontrolleri bu riski azaltır.
Kurulum ve işletme maliyetleri; depolama hacmine, veri alım sıklığına, işleme motoruna, sorgu yüküne ve saklama süresine bağlıdır. Gerçek zamanlı akışların yoğunluğu ve kapsamlı dönüşüm işleri de kaynak tüketimini etkileyebilir. Bu nedenle maliyeti yalnızca depolanan veri miktarına göre değil, verinin nasıl işlendiğine ve ne sıklıkta okunduğuna göre değerlendirmek gerekir.
Ölçeklenebilirlik ve farklı veri türlerini desteklemesi, veri gölünün önemli avantajlarındandır. Yapılandırılmamış çağrı kayıtları, uygulama günlükleri ve ilişkisel satış tabloları aynı mimaride tutulabilir. Yeni bir kaynak eklendiğinde mevcut tabloları baştan tasarlamadan veri alımı genişletilebilir. Makine öğrenmesi ekibi daha sonra müşteri kaybı tahmini için gerekli kayıtları seçip hazırlayabilir. Veri hacmi ve kullanım senaryoları arttıkça bu esneklik daha değerli hâle gelir.
Ancak ham verinin çokluğu tek başına analiz kalitesini artırmaz. Veri gölünde yönetişim ve veri kalitesi; katalog, veri kökeni, sahiplik, kalite kontrolleri ve erişim politikalarıyla sağlanır. Örneğin müşteri kayıtlarında eksik alanlar varsa veri ürününün tanımına kalite kuralları eklenir ve dönüşüm sırasında sonuçlar izlenir. Güncellik ve güvenilirlik bilgileri de veri kümesiyle birlikte tutulur.
Güvenlik tasarımında kişisel veriler, kullanım amacı ve kullanıcı rolü dikkate alınarak ayrıştırılmalıdır. Örneğin ham müşteri kayıtlarına erişim, analiz için hazırlanmış toplulaştırılmış görünümlerden ayrı tutulabilir. Hassas alanlar analitik kullanıcılara açılmadan önce maskelenebilir veya kapsamları daraltılabilir. Erişim kayıtlarını düzenli incelemek beklenmeyen kullanım örüntülerini görünür kılar. Bu önlemler, veri gölü tasarımında güvenlik ve mahremiyet risklerini birlikte yönetmeye yardımcı olur.
Performans, seçilen işleme motoruna göre değişebilir. Örneğin büyük günlük dosyalarını toplu işleyen bir süreç ile anlık olayları inceleyen bir akış farklı miktarda kaynak tüketir. İş yükü, sorgu biçimi ve veri düzeni birlikte değerlendirilmelidir. Saklama katmanları da kullanım sıklığına göre ayrılabilir. Böylece sık analiz edilen verilerle uzun süre saklanması gereken kayıtlar farklı biçimde yönetilir.
Bu kontrollerin kurumsal raporlama ortamına yansıması için katalog ve erişim kurallarının Power BI yönetişimiyle tutarlı olması gerekir. Power BI Danışmanlık ve Yönetişim kapsamında veri kullanımı, güvenlik ve kontrollü self-servis raporlama birlikte ele alınabilir.
Kataloglama, veriyi bulunur kılmanın ötesinde, onu değerlendirecek kişiye bağlam sunmalıdır. İçerik, kaynak, sahip, güncellenme sıklığı, güvenilirlik ve erişim bilgileri birlikte kaydedildiğinde kullanıcılar veri kümesinin neyi temsil ettiğini ve ihtiyaçlarına uygun olup olmadığını anlayabilir. Bu bilgilerin tutarlı tutulması, benzer verilerin farklı biçimlerde yorumlanma riskini azaltır. Katalog kayıtları güncel değilse arama ve seçim süreçleri yanıltıcı olabilir. Bu nedenle katalog, veri gölü işletiminin düzenli olarak gözden geçirilmesi gereken bir parçasıdır.
Erişim politikaları yalnızca kimin veriyi açabileceğini değil, saklama süresini, erişimin nasıl denetleneceğini ve hassas bilgilerin nasıl korunacağını da belirlemelidir. Bu unsurlar açıkça tanımlandığında, kullanıcıların ihtiyaç duyduğu erişimle verinin korunması arasında tutarlı bir çerçeve kurulur. Politikalara uygunluk denetimlerle izlenebilir; hassas bilgilerin korunması da erişim kararlarının parçası hâline gelir. Performans açısından aynı veri ve iş yükü farklı işleme motorlarında aynı sonucu vermeyebilir. Bu nedenle motor seçimi, gölün kullanım biçimiyle birlikte değerlendirilmelidir. İşleme tercihleri de katalog ve erişim kuralları kadar işletim deneyimini etkiler. Bu alanları birlikte ele almak, veri gölünün yönetimini daha öngörülebilir kılar.
Veri göllerinde şema okuma yaklaşımı
Şema okuma yaklaşımında verinin yapısı depoya yazılırken değil, sorgulanırken yorumlanır. Örneğin uygulama günlükleri ham biçimleriyle saklanabilir. Analist belirli bir soruyu yanıtlamak istediğinde ilgili alanları seçer, ardından tarih, kullanıcı ve işlem gibi alanların anlamını tanımlar. Bu yöntem, büyük veri kaynaklarını alım öncesinde tek bir yapıya zorlamaz. Farklı analiz ihtiyaçları için aynı kayıt kümesinden ayrı görünümler oluşturulabilir.
Bunun karşıtı, şemanın yazma sırasında uygulanmasıdır. Veri ambarında kayıtlar depoya girmeden önce tanımlanmış tablolara ve veri türlerine uymalıdır. Örneğin satış tarihi tarih alanına, tutar ise sayısal alana yazılır. Böylece raporlar tutarlı bir yapıda çalışır. Veri gölünde aynı kaynak önce özgün biçimiyle alınabilir; yapı, okuma ve işleme aşamasında belirlenir. Bu ayrım, esneklik ile erken doğrulama arasındaki tercihi ortaya koyar.
Bir çevrim içi mağazanın olay kayıtlarını düşünelim. JSON biçimindeki kayıtlar, ürün görüntüleme ve sepete ekleme bilgilerini içerebilir. Pazarlama analisti oturum ve kampanya alanlarını okurken ürün ekibi ürün kodu ve görüntüleme zamanına odaklanabilir. Her ekip aynı geçmiş kayıtlara farklı bir şema uygulayabilir. Böylece yeni bir iş sorusu ortaya çıktığında kaynak veriyi yeniden toplamak gerekmez. Ancak alanların tanımı ve anlamı belgelenmelidir.
Şema okuma, kaynak biçimindeki değişikliklere uyumu kolaylaştırır ancak denetim gereksinimini ortadan kaldırmaz. Örneğin uygulama ekibi bir alana yeni değerler eklediğinde mevcut sorgular bu değişikliği doğru yorumlamayabilir. Veri sözlüğü; alan adını, türünü, açıklamasını ve kaynağını kaydeder. Sorgu öncesi doğrulama, beklenmeyen boşlukları veya tür uyuşmazlıklarını belirler. Bu kontroller olmazsa aynı alan farklı raporlarda farklı anlamlar taşıyabilir.
İşleme motoru, şemanın nasıl uygulanacağını ve sorgu performansını etkiler. Örneğin bir sorgu yalnızca belirli tarihlerdeki olayları kullanıyorsa ilgili alanları ve kayıtları hedefleyecek şekilde tasarlanmalıdır. Her sorguda tüm dosyaları taramak gereksiz işlem yükü oluşturabilir. Bu nedenle veri düzeni, sorgu örüntüleriyle birlikte planlanır. Büyük veri kümelerinde katalog ve bölümleme tercihleri, ilgili kayıtların bulunmasını kolaylaştırır.
Her veri kümesine tek bir şema uygulamak gerekmez. Finans raporu onaylanmış satış alanlarını, ürün analizi ise tıklama olaylarının ayrıntılarını kullanabilir. Bu görünümlerin aynı kaynağa dayanması, tanımların ortaklaştırılmasını daha da önemli kılar. Örneğin “işlem tarihi” alanının olay zamanını mı yoksa sisteme geliş zamanını mı gösterdiği açıkça belirtilmelidir. Böylece farklı analizler karşılaştırılabilir sonuçlar üretir.
Kapsamlı mimarilerde şema hem yazma hem okuma sırasında uygulanabilir. Örneğin hassas veya kritik bir veri kümesi alınırken temel alan denetimleri yapılır; analitik ekipleri daha sonra kullanım amacına uygun ek yapılar tanımlar. Bu birleşik yaklaşım, ham veriyi korurken belirli kuralların erken uygulanmasını sağlar. Karar; kaynakların değişkenliğine, raporlama beklentisine ve kalite gereksinimlerine göre verilir. Şema politikası, veri kataloğunda ve işlem akışında tutarlı biçimde belgelenmelidir.
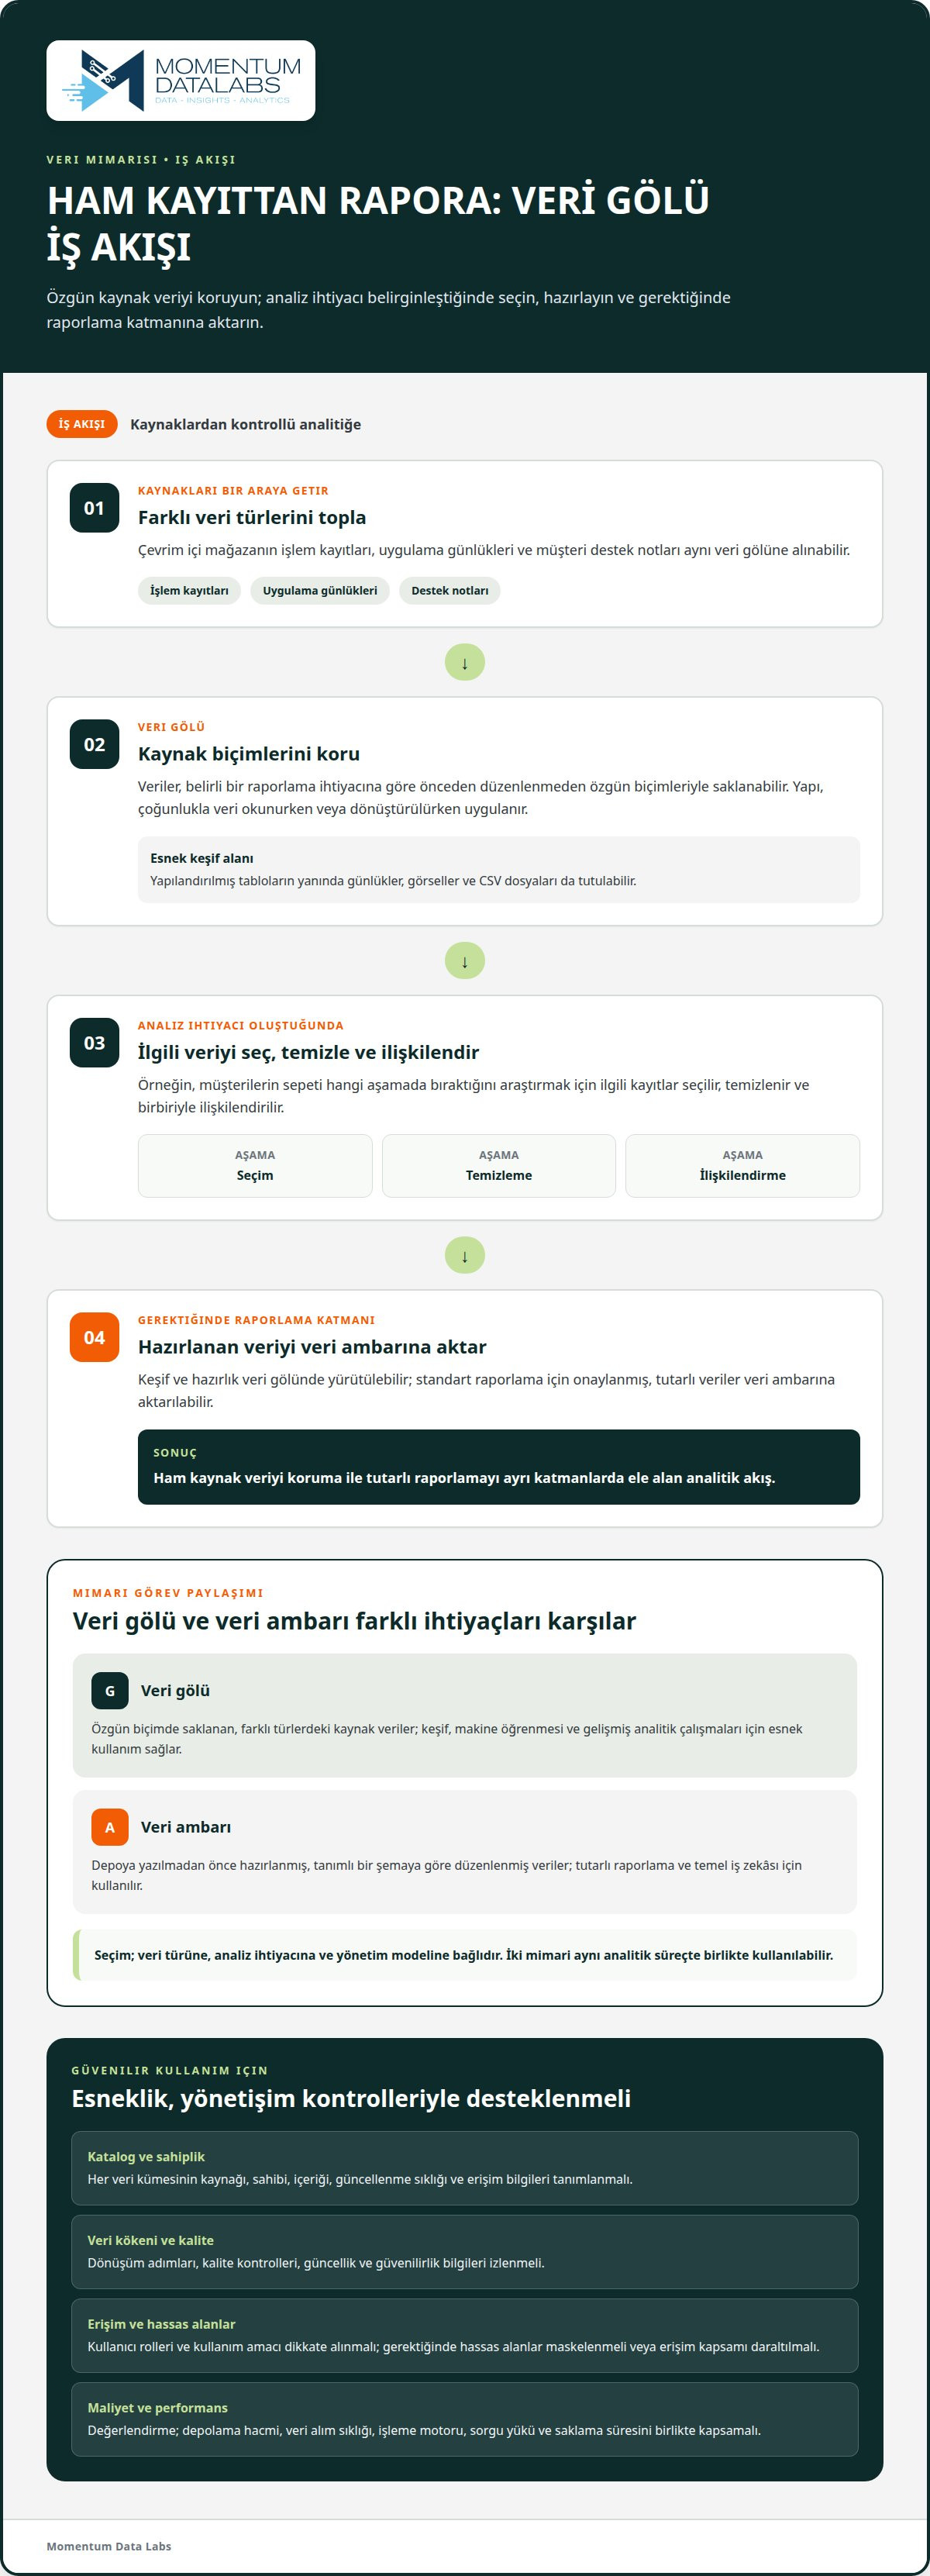
Veri gölünün tanımı ve iş akışı
Veri gölünün temel bileşenleri; kaynaklardan veri alımı, ölçeklenebilir depolama, katalog, işleme katmanı, erişim denetimi ve analiz araçlarıdır. Örneğin satış sistemi, internet sitesi ve uygulama günlükleri aynı mimariye veri sağlayabilir. Katalog ise bu veri kümelerinin kaynağını ve kullanımını açıklar.
Kurulumda önce iş hedefi ve veri kaynakları belirlenir; ardından depolama, erişim, kataloglama ve işleme tasarlanır. Son aşamada veriler doğrulanır, uygun analiz araçlarına sunulur ve izleme kuralları tanımlanır.
Bu akışın ayrıntıları, kurumun kaynak sistemlerine ve analiz ihtiyacına göre değişir. Örneğin internet mağazası verileri sisteme aktarılırken her kayıt kaynağıyla ilişkilendirilir. Ham kopya korunur; analiz ihtiyacı ortaya çıktığında dönüşüm süreci devreye girer. Böylece veri alımıyla iş kurallarının uygulanması birbirinden ayrılır. Yeni bir rapor veya araştırma talebinde kaynak veriyi yeniden toplamadan çalışmak mümkün olur.
- Kaynakları belirleme: CRM, satış uygulaması ve olay günlükleri gibi sistemler seçilir. Her kaynağın veri sahibi ve güncellenme düzeni kaydedilir.
- Veriyi alma: Dosya aktarımı veya akış, kaynak kayıtlarını depolama alanına taşır. Örneğin mağaza işlemleri düzenli aktarılırken uygulama olayları akışla alınabilir.
- Veriyi depolama: Yapılandırılmış ve yapılandırılmamış kayıtlar, özgün biçimleriyle saklanabilir. Kaynak, tarih ve erişim bilgileri katalogda tutulur.
- Veriyi işleme: İlgili kayıtlar temizlenir, doğrulanır ve kullanım amacına göre dönüştürülür. Satış analizi için işlem tarihi ve ürün kodu eşleştirilebilir.
- Veriyi sunma: Onaylanmış veri kümeleri raporlama, SQL sorguları veya makine öğrenmesi süreçlerine açılır. Yetkiler, kullanıcı rolüne göre belirlenir.
Depolama katmanı; günlük dosyaları, CSV tabloları ve görüntüler gibi farklı içerikleri bir arada tutabilir. Nesne depolama, dosya ve klasör düzenine bağlı kalmadan büyük hacimli verileri saklamaya olanak tanır. Depolama biçimi, erişim sıklığı ve analiz araçlarıyla birlikte seçilir. Örneğin geçmiş uygulama kayıtları uzun süre korunurken sık sorgulanan satış verileri analiz için hazırlanabilir. Bu ayrım, ölçeklenebilirlik planının bir parçasıdır.
Katalog yalnızca dosya adlarını listelemez; veri kümesinin açıklamasını, kaynağını, sorumlusunu, güncellik bilgisini ve erişim koşullarını bir araya getirir. Örneğin “sipariş olayları” kaydının hangi uygulamadan geldiği ve hangi alanları içerdiği belirtilir. Veri kökeni bilgisi, dönüşüm adımlarının izlenmesini sağlar. Böylece rapordaki bir ölçümün hangi kaynaklara dayandığı görülebilir.
İşleme katmanında ham kayıtlar, analize uygun veri ürünlerine dönüştürülür. Örneğin ürün görüntüleme olayları oturum bilgileriyle ilişkilendirilerek kullanıcı yolculuğu kapsamında incelenebilir. Dönüşüm kuralları veri kalitesini ve tutarlılığı etkiler. Bu nedenle hatalı biçimler, eksik değerler ve yinelenen kayıtlar süreç içinde ele alınır. Sonuçlar raporlara veya analitik uygulamalara aktarılmadan önce tanımlanan kalite kontrollerinden geçirilir.
Güvenlik ve izleme, mimarinin sürekli çalışan parçalarıdır. Erişim kontrolleri hassas müşteri kayıtlarını yalnızca yetkili rollere açar. İzleme süreçleri veri alımındaki kesintileri, güncellenmeyen kümeleri ve işlem hatalarını görünür kılar. Örneğin beklenen satış dosyası gelmediğinde ilgili akış incelenebilir. Bu kontroller, depolama alanı büyürken yönetim süreçlerinin de uyumlu biçimde ilerlemesine yardımcı olur.
Veri göllerinin işletmeler için önemi
Bir şirket, farklı sistemlerden gelen verileri birlikte analiz ederek operasyonel siloları azaltabilir. İşlem kayıtları, pazarlama etkileşimleri ve destek verileri aynı analitik çalışmada değerlendirilebilir. Örneğin müşteri kaybını anlamak için satın alma geçmişi, ürün kullanımı ve destek başvuruları bir araya getirilebilir. Bu veriler, yalnızca CRM'de tutulan özetlerden daha ayrıntılı davranış örüntüleri sunabilir.
Veri gölleri, büyük miktarda ham veriyi saklayıp yeni iş sorularına göre incelemeyi sağlar. Bu yaklaşım, verinin gelecekteki kullanım amacının baştan kesinleşmesini gerektirmez. Veri bilimciler mevcut kümeleri keşfedebilir, özellikler oluşturabilir ve tahmine dayalı analiz için veri hazırlayabilir. Örneğin geçmiş satışlar, mevsimsel talep ve kampanya bilgileri talep tahmininde kullanılabilir.
Makine öğrenmesi ve gelişmiş analitik, veri göllerinin kurumsal fayda sağlayabildiği alanlardandır. Apache Spark veya Hadoop gibi işleme araçları büyük veri kümelerinde analitik iş yükleri çalıştırabilir. Derin öğrenme uygulamalarında eğitim verisi miktarı arttıkça depolama ve işleme mimarisinin ölçeklenebilir olması gerekir. Bu esneklik, şirketlerin deneme çalışmalarını üretim süreçlerinden ayrı değerlendirmesine de yardımcı olur.
Keşif çalışmaları, bir iş fikrini daha geniş ölçekte uygulamadan önce sınamayı sağlar. Örneğin dolandırıcılık tespiti için işlem örüntüleri incelenebilir veya öneri sistemleri için ürün etkileşimleri araştırılabilir. Ekip, ilgili verileri seçip model varsayımlarını test eder. Sonuçlar iş değeri gösterdiğinde tekrar kullanılabilir veri kümeleri ve kontrollü işleme akışları oluşturulabilir.
Gerçek zamanlıya yakın analizler de karar süreçlerini destekleyebilir. Örneğin çevrim içi hizmetlerde olay kayıtları, kullanıcı davranışındaki değişimleri izlemek için değerlendirilebilir. Pazarlama ekibi kampanya etkileşimlerini, operasyon ekibi ise işlem akışındaki olağan dışı durumları inceleyebilir. Hangi kararların anlık veri, hangilerinin geçmiş kayıtlar gerektirdiğini baştan ayırmak önemlidir. Böylece her iş yükü uygun veri işleme düzenine yönlendirilir.
- Müşteri analitiği: İşlem, web davranışı ve destek verileri birleştirilerek müşteri yolculuğu incelenebilir.
- Tahminleme: Geçmiş satış ve ürün verileri, talep veya müşteri kaybı tahminlerinde kullanılabilir.
- Deney ve keşif: Yeni analitik fikirleri, mevcut kayıtlarla sınanarak sonraki çalışmalar için yön belirleyebilir.
- Arşivleme ve kurtarma: Etkin kullanılmayan veriler, ilerideki analizler veya kurtarma senaryoları için saklanabilir.
Sonuç olarak işletme için değer, yalnızca depolanan veri hacminden doğmaz. Analiz sorusunun netliği, verinin bulunabilirliği ve çıktının karar süreçlerine bağlanması belirleyicidir. Veri bilimciler, mühendisler ve analistler aynı tanımları kullandığında çalışmalar karşılaştırılabilir hâle gelir. Örneğin tahmin sonucu stok planlamasına aktarılabilir; böylece analitik çıktı günlük iş kararlarıyla ilişkilendirilir.
İleride düzenleyici soruşturmalar veya yeni analizler için gerekebilecek soğuk ya da etkin olmayan veriler düşük maliyetle saklanabilir. Geniş depolama alanı ve görece düşük maliyetleri, veri göllerini felaket kurtarma için alternatif depolama seçeneği haline getirir. Böylece arşivleme ve kurtarma amaçları aynı depolama yaklaşımıyla desteklenebilir. Momentum Data Labs araştırmasına katılan işletmelerin yarısından fazlası, anket sırasında bir veri gölü uygulamıştı. Bu uygulama, veri göllerinin kurumsal kullanım alanlarının çeşitliliğini yansıtır.
Veri gölleri makine öğrenmesi, tahmine dayalı analiz ve gerçek zamanlı analiz için kullanılabilir. Metin sınıflandırma gibi kavram kanıtlama projelerinde ya da büyük veri analitiği projeleri için kum havuzu olarak da değerlendirilebilir. Bu tür çalışmalar, yeni analitik yaklaşımların sınanmasına ve iş yüklerinin geliştirilmesine alan açar. Ayrıca veri gölleri, veri işlem hatlarını, akış analitiğini ve makine öğrenimi iş yüklerini herhangi bir bulutta çalıştırmayı daha kolay ve daha ucuz hale getirebilir. Soğuk verilerin saklanması, gelecekte ortaya çıkabilecek inceleme ve analiz gereksinimleri için de kullanılabilir durumda tutulmalarını sağlar.
Momentum Data Labs
Momentum Data Labs, işletmenizin veri mimarisini iş hedefleri, analitik ihtiyaçları ve yönetişim gereksinimleri doğrultusunda şekillendirmenize yardımcı olur. Veri kaynaklarını, depolama yaklaşımını ve analiz süreçlerini birlikte değerlendirmek, esneklik ile güvenlik ve sürdürülebilirlik arasında denge kurmayı destekler.
Yeni bir lakehouse mimarisi tasarlarken Veri Ambarı ve Lakehouse Tasarımı çalışmaları, verinin yapısını ve kullanım akışını planlamaya odaklanır. Mevcut ortamını modernize etmek isteyen işletmeler Fabric Geçiş ve Modernizasyon desteğinden; raporlama modellerini iyileştirmeyi hedefleyen ekipler Veri Modelleme ve DAX Optimizasyonu çalışmalarından yararlanabilir. Ekiplerin teknik yetkinliklerini geliştirmek için Eğitim Çözümleri de sürece eşlik edebilir.
Mimari hedeflerinizi ve veri yönetiminde karşılaştığınız zorlukları değerlendirmek için Momentum Data Labs ile iletişime geçin.
Veri yaklaşımınızı iş hedefleriyle eşleştirin
Bir sonraki adım, veri gölleri yaklaşımını belirli bir iş kararına bağlamaktır. Öncelikli kullanım senaryosunu, verinin sorumlusunu ve analitik çıktıyı kullanacak ekibi netleştirmek, mimari tercihleri somutlaştırır. Böylece teknoloji seçimi tek başına bir hedef olmaktan çıkar ve işletmenin karar süreçlerini destekleyen bir yapıya dönüşür.
Momentum Data Labs; veri ortamını iş ihtiyaçlarıyla uyumlandırmak için Power BI Danışmanlık ve Yönetişim, Microsoft Fabric Geçiş ve Modernizasyon Danışmanlığı ile Power BI Veri Modelleme ve DAX Optimizasyonu hizmetleri sunar. Bu hizmetler mevcut mimariyi değerlendirmek, geçiş yaklaşımını planlamak veya analitik modelleri iyileştirmek istediğinizde yararlı olabilir. Öncelikli konuyu belirlemek için veri hedeflerinizi ve karşılaştığınız engelleri Momentum Data Labs ile değerlendirin.
İş hedeflerinize uygun sonraki adımı konuşmak için Momentum Data Labs ile iletişime geçin. Net bir kullanım amacıyla başlayan plan, veriden sürdürülebilir iş değeri üretmek için sağlam bir temel oluşturur.
Sıkça Sorulan Sorular
Veri gölleri işletmeler için neden önemlidir?
Bu mimari, analitik ekiplerinin aynı veri varlığı üzerinde izlenebilir çalışmalar yürütmesine yardımcı olur. Örneğin operasyon ekibi teslimat gecikmelerini incelerken veri kümesinin güncelliğini ve dönüşüm geçmişini görebilir. Böylece bulguların hangi kaynaklara dayandığı açıklanabilir. Kurum içinde ortak veri tanımları oluşturmak, farklı ekiplerin benzer göstergeleri farklı kurallarla hesaplama riskini de azaltır.
Veri gölü nedir, nasıl çalışır?
Veri gölü, analiz ve veri işleme süreçlerine kaynak sağlayan merkezî bir veri ortamıdır. İşleyişte katalog bilgileri, erişim izinleri ve veri kökeni kayıtları birlikte yönetilir. Örneğin bir rapor hatalı sonuç verdiğinde ekip, kullanılan veri kümesinin son güncellemesini ve uygulanan dönüşümleri izleyebilir. Bu izlenebilirlik, sorunun kaynağını belirlemeyi ve ilgili işleme adımını kontrollü biçimde düzeltmeyi kolaylaştırır.
Veri gölü ile veri ambarı arasındaki farklar nelerdir?
İki mimari, veri tanımlarındaki değişiklikleri ve kalite kontrollerini farklı aşamalarda ele alabilir. Yeni bir kaynak alanı eklendiğinde göl ortamında bu alanın etkisi belirli bir analiz görünümünde değerlendirilebilir. Ambar tarafında ise raporlama tabloları ve ölçüm tanımlarıyla uyum korunmalıdır. Bu nedenle mimari kararında yalnızca depolama biçimini değil, değişikliklerin nasıl test edileceğini ve iş birimlerince nasıl onaylanacağını da dikkate almak gerekir.
Veri gölü hangi kullanım alanlarında tercih edilir?
Farklı zamanlarda toplanan teknik kayıtların karşılaştırılması gerektiğinde bu yaklaşım yararlı olabilir. Örneğin bakım ekipleri üretim hattındaki titreşim ölçümlerini bakım formlarıyla eşleştirerek arıza öncesi işaretleri araştırabilir. Böyle bir çalışma için zaman damgalarının ortak anlamı, cihaz kimliklerinin tutarlılığı ve ölçümlerin açıklamaları önemlidir. Bu koşullar sağlandığında analitik ekip, bakım planlamasına yönelik sınanabilir bulgular üretebilir.